Sind KI-geschriebene Keywords auf Stock-Seiten erlaubt?
Keine Stock-Agentur verbietet KI-Keywords. Adobe Stock, Shutterstock, Pond5 und Getty bestrafen Spam, irrelevante Wörter, Marken. Mit Datum und Quellen.

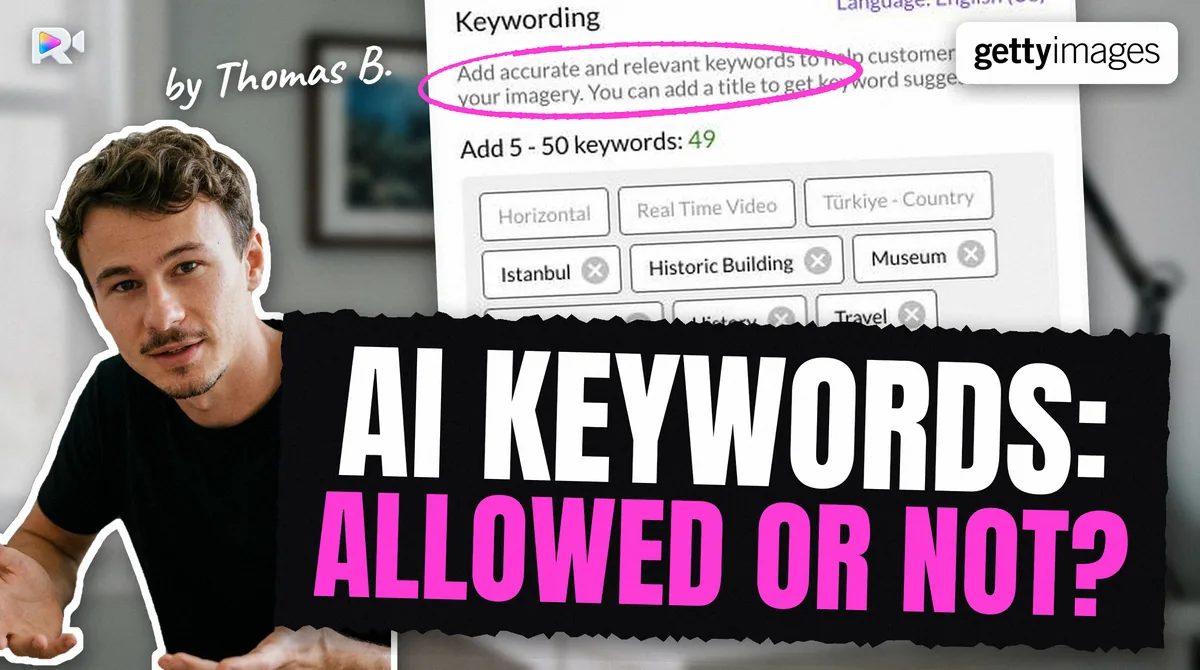
Ja, soweit sich irgendeine Agentur geäußert hat. Auf den Seiten, die wir im Oktober 2026 gelesen haben, verbietet oder erlaubt keine der Agenturen Adobe Stock, Shutterstock, Pond5 und Getty KI-geschriebene Keywords, und Adobe und Getty bieten eigene Vorschläge an. Bestraft wird, was die Wörter sagen: irrelevante Keywords, wiederholte Wörter, Markennamen und Spam, auch wenn nicht jede Agentur alle vier nennt.
Das ist die nützliche Antwort, denn sie verschiebt die Frage. Das Risiko ist nicht, dass ein Prüfer ein Tool erkennt. Das Risiko ist, dass ein Auto-Keyword-Tool genau die Wörter liefert, die die Regeln verbieten, und dass du sie ungelesen sendest. Diese Seite zeigt, was jede Agentur tatsächlich bestraft, wie KI-Keywords scheitern und wie Rushlot seine eigenen Entwürfe prüft.
Verbieten Adobe, Shutterstock, Pond5 oder Getty KI-geschriebene Keywords?
Nein. Wir haben bei keiner der vier eine Seite gefunden, die von KI geschriebene Metadaten verbietet oder gutheißt. Mindestens zwei von ihnen schreiben sogar Keywords für dich:
- Adobe Stock schlägt in seinem eigenen Uploader Keywords vor, bis zu 25 pro Datei (Adobe-Hilfe, "Keyword and title best practices").
- Getty hat in ESP, seinem Upload-Tool, einen Button "Get suggestions" (gesehen auf einem aktiven Konto am 2026-09-08).
Manche Anbieter von KI-Keyword-Tools schreiben, dass "human reviewers reject unnatural metadata" (menschliche Prüfer unnatürliche Metadaten ablehnen). Wir haben keine Agenturseite gefunden, die das sagt. Nimm es als Marketing, nicht als Regel.
Eine verwandte Regel gibt es tatsächlich. Für Inhalte, die selbst mit generativer KI erstellt sind, verbietet Adobe, in den Metadaten reale Personen oder geistiges Eigentum Dritter zu nennen (Adobe-Hilfe, "Generative AI content"). Dabei geht es darum, was die Wörter benennen, nicht darum, wer sie geschrieben hat.
Was bestrafen die Agenturen tatsächlich?
Die Wörter, egal woher sie kommen. Hier ist, was jede Agentur veröffentlicht.
| Agentur | Was abgelehnt wird | Wie weit es gehen kann | Quelle (Datum) |
|---|---|---|---|
| Adobe Stock | Unangemessene oder irrelevante Keywords; Logos, Firmennamen und Marken in den Metadaten | Spam "can even lead to your account being closed" | Common reasons for refusal (2026-06-11); Account and submission guidelines (2026-09-03); Artist Hub (gelesen 2026-10-01) |
| Shutterstock | Wiederholte Wörter oder Wendungen; irrelevante oder unvollständige Keywords; eine Wortliste statt eines Satzes (Titel) | Ein Keyword wieder hinzuzufügen, das seine Mitarbeiter entfernt haben, ist ein Verstoß; wiederholte Verstöße führen zu Sperrung oder Kündigung | Rejected for title or keywords (2025-09-13); Keyword spamming (2025-07-18); Account guidelines (2025-09-23) |
| Pond5 | Das Vollstopfen von Titeln oder Keywords "will result in rejection" | Nicht angegeben | Tagging & Pricing (gelesen 2026-10-27) |
| Getty iStock | Keywords außerhalb seines kontrollierten Vokabulars bleiben rot; "quality over quantity" | Keyword-Doping ist durch seine Contributor-Vereinbarung verboten | Artikel 6064 (gelesen 2026-10-01); Vereinbarung 4872 (Suchauszug); ESP gemessen 2026-09-08 |
Shutterstock liefert die klarste Definition: Keyword-Spamming ist "overusing repeated or irrelevant terms" (übermäßiger Gebrauch wiederholter oder irrelevanter Begriffe). Die Zeilen unterscheiden sich im Detail, zeigen aber in dieselbe Richtung: Ein Keyword muss beschreiben, was ein Käufer im Clip sehen wird.
Wie liegen KI-Keyword-Tools daneben?
Auf sechs vorhersehbare Arten. Die meisten entsprechen einer Regel oben.
- Generische Füllwörter. Beautiful, amazing, background, concept. Verlangt man 49, füllt ein Modell 49. Irrelevant bei jeder Agentur.
- Wiederholte Wortstämme. Swim, swimming, swimmer, swims. Shutterstock nennt wiederholte Wörter als Ablehnungsgrund.
- Marken und Kameranamen. GoPro, iPhone, der Name eines Bootsherstellers. Adobe verbietet Marken in den Metadaten.
- Falsche Art. Ein Modell nennt anhand des Bildes einen plausiblen Fisch. Ist er falsch, ist das eine falsche Behauptung, die ein Käufer in Sekunden prüfen kann.
- Die falsche Sprache. Shutterstock will englische Beschreibungen, abgesehen von lateinischen Namen, Orten und gängigen fremdsprachigen Begriffen (Contextual Metadata, 2026-02-26).
- Verirrtes Markup. Ein Modell kann ein Tag oder eine Notiz in seiner Ausgabe stehen lassen. Einer unserer Entwürfe begann eine Beschreibung mit einem erfundenen Tag, das auf
>endete: Shutterstock lehnte die Zeile ab, Adobe nahm es als Titel des Clips, und Pond5s Seite zeigte den Clip ganz ohne Titel.
Die letzten beiden sind uns passiert. Beide kamen aus Rushlots eigenen frühen Entwürfen, auf dem Konto von Hervé Berthou, meinem Vater, der vorher ChatGPT für seine Metadaten genutzt hatte. Ein französisches Keyword, tonne de chasse, erreichte Shutterstock in einem Batch im September 2026: Keywords wurden damals noch nicht auf ihre Sprache geprüft.
Warum ist es so langsam, jedes KI-Keyword von Hand zu prüfen?
Weil sich die Prüfungen vervielfachen. Vierzig Keywords, vier Agenturen, jede mit ihrer eigenen Anzahl, ihren eigenen Sprach- und Zeichenregeln und ihren eigenen verbotenen Wörtern: Ein Clip bedeutet, die Liste auf vier Arten zu lesen. Die meisten hören nach den ersten paar Clips auf zu lesen, und genau dann rutscht eine Marke, ein falscher Binomialname oder ein französisches Wort durch. Die Agentur sagt dir nicht, welches Wort das Problem war, und bei Shutterstock verschwinden manche Wörter einfach.
Wie prüft Rushlot die Keywords, die es entwirft?
Mit drei Prüfstufen, jede nach einem echten Fehler gebaut. Ausführlich beschrieben sind sie in wie wir wissenschaftliche Namen prüfen.
1. Dein Titel ist die Quelle. Du weißt, was du gefilmt hast; ein Modell, das Einzelbilder anschaut, weiß es nicht. Rushlot erweitert deinen Titel zu Keywords. Ein Vision-Durchgang ergänzt, was ein Titel nicht sagen kann (Einstellungsgröße, Kamerabewegung, Licht), und wenn er deinem Titel widerspricht, markiert er das für dich. Er überschreibt nie deine Worte.
2. Jeder lateinische Name wird gegen WoRMS geprüft. WoRMS, das World Register of Marine Species, enthält auch Süßwasserarten. Die Regeln, gemessen am 2026-09-03:
| WoRMS antwortet | Was Rushlot veröffentlicht |
|---|---|
| HTTP 200, akzeptierter Name | Den Namen |
| HTTP 200, Name nicht akzeptiert | Den aktuell gültigen Namen (Manta birostris wird zu Mobula birostris) |
| HTTP 204 (kein Eintrag) | Nichts. Ein Tippfehler (Esox luciuss) und ein erfundener Name (Sander fictus) liefern beide 204 |
| Keine Antwort | Nichts. Ein Ausfall ist kein Urteil |
Wenn ein Name durchfällt, geht Rushlot eine Stufe zurück auf die Gattung, dann die Familie, dann ein schlichtes Allgemeinwort. Es veröffentlicht nie einen Namen, den es nicht prüfen konnte.
3. Nichts geht ungelesen raus. Vor dem Upload liest Rushlot den generierten Titel und die generierte Beschreibung (nie deinen Originaltitel) und stoppt einen Clip, dessen Text sich französisch liest, Markup wie < oder > enthält, einen leeren Titel hat oder einen Titel, der für Pond5s 80 Zeichen zu lang ist. Keywords werden auf Markup geprüft. Die Prüfung läuft zweimal: beim Entwerfen und noch einmal kurz bevor der Upload startet. Seit dem 27. September 2026 wird ein Keyword mit französischem Akzent oder französischen Funktionswörtern verworfen und markiert, außer der englische Titel verwendet dieselben Wörter.
Zwei Regeln kommen obendrauf. Die Keyword-Anzahl ist eine Obergrenze, nie eine Quote: Unter 15 wird markiert, nie mit Vermutungen aufgefüllt. Und ein Wortstamm wird nur einmal verwendet.
Marken- und Kameranamen prüfst du selbst, mit Frage 2 unten.
Wie prüfe ich KI-Keywords vor dem Upload selbst?
Lass die Liste durch fünf Fragen laufen, in dieser Reihenfolge:
- Kann ich dieses Wort im Clip sehen? Wenn nicht, lösch es.
- Ist es eine Marke, ein Produkt, eine Person oder ein Ort, den ich nicht bestätigen kann? Lösch es.
- Steht der lateinische Name in WoRMS (oder in GBIF, nur bei exaktem Treffer, für Landarten)? Wenn nicht, nimm die Gattung oder ein schlichtes Allgemeinwort.
- Kommt ein Wortstamm zweimal vor? Behalte einen.
- Steht das wichtigste Wort unter den ersten 10? Bei Adobe zählt die Keyword-Reihenfolge: Es muss dort stehen.
Das Tool unten erledigt die Fragen 4 und 5 in deinem Browser: Es entfernt Duplikate und wiederholte Wortstämme, behält deine Reihenfolge bei und zeigt Adobes erste 10.
Welche KI-Keyword-Generatoren funktionieren mit Video?
Mehrere, und sie unterscheiden sich darin, was mit der Datei passiert. In unserer Übersicht vom 8. November 2026 drehen sich fünf Tools um das Entwerfen von Stock-Footage-Metadaten: AI Stock Keywords, AutoKeyWorder, ClipMeta, PhotoKeyworder und Stocktag. ClipMeta ist nur für Video gebaut und sendet Dateien außerdem per FTP an Blackbox. AI Stock Keywords und PhotoKeyworder sagen, dass Video-Metadaten außerhalb der Datei bleiben. SendStock AI sagt, es bette Metadaten in MP4 und MOV ein. Wir bauen selbst eines dieser Tools, deshalb ranken wir keines: unser Vergleich von Stock-Footage-Software führt jedes anhand seiner eigenen Seiten auf, und Rushlot vs ClipMeta stellt zwei nebeneinander. Jede Regel oben gilt, egal welches Tool die Wörter entwirft.
Was ist noch unbekannt?
Ob irgendeine Agentur KI-geschriebene Metadaten als solche erkennt. Keine Agentur sagt, dass sie es tut, oder dass sie es nicht tut. Wir haben auch keine offizielle Aussage gefunden, dass das massenhafte Bearbeiten von Metadaten ein Konto gefährdet: Ein Contributor in Adobes Forum berichtete von einer Deaktivierung am Tag, nachdem er etwa 70 Dateien korrigiert hatte (August 2026), ohne offizielle Erklärung, die wir hätten finden können.
Jede Agentur hat ihre eigenen Keyword-Limits, und Getty behält nur Wörter aus seinem kontrollierten Vokabular. Wenn du ein Tool auswählst: Ein guter Stock-Footage-Metadaten-Generator muss mehr können, als das Keyword-Feld zu füllen. Die Direktvergleiche stellen echte Tools gegenüber: Rushlot vs MetaMule, Rushlot vs SendStock AI, Rushlot vs MyKeyworder. Die Agenturseiten (Adobe Stock, Shutterstock, Pond5, Getty Images) nennen die Specs jeder Agentur. Die Download-Seite sagt, wie du die Rushlot-App für Mac und Windows bekommst.
Häufige Fragen
Auf den Seiten, die wir gelesen haben, verbietet oder erlaubt Adobe sie nirgends. Es lehnt irrelevante Keywords ab und sagt, Keyword-Spam könne zur Schließung eines Kontos führen. Adobes eigener Uploader schlägt ebenfalls Keywords vor. Das Werkzeug ist nicht das Problem; die Wörter sind es.
Nicht als solche. Shutterstock lehnt wiederholte Wörter und irrelevante oder unvollständige Keywords ab, definiert Keyword-Spam als übermäßigen Gebrauch wiederholter oder irrelevanter Begriffe und wertet es als Verstoß, ein Keyword wieder hinzuzufügen, das seine Mitarbeiter entfernt haben.
Ja, als Entwurf, den du prüfst. Entferne jedes Wort, das im Clip nicht zu sehen ist, jede Marke, jeden wiederholten Wortstamm und jeden lateinischen Namen, den du nicht verifizieren kannst. Der Titel bleibt in deinen eigenen Worten.
Adobe sagt, Keyword-Spam 'can even lead to your account being closed' (kann sogar zur Schließung deines Kontos führen). Shutterstocks Konto-Richtlinien eskalieren wiederholte Verstöße bis zur Sperrung oder Kündigung. iStocks Vereinbarung verbietet Keyword-Doping (gelesen in einem Suchauszug).
Sie können sie erfinden oder falsch schreiben. Prüfe jeden Binomialnamen gegen ein taxonomisches Register wie WoRMS: Ein falsch geschriebener oder erfundener Name liefert HTTP 204 und sollte verworfen werden.
Wir ranken sie nicht, und wir bauen selbst einen. Prüfe bei jedem Tool drei Dinge: dass es Video liest, dass es von deinem eigenen Titel ausgeht und wie die Metadaten zu jeder Agentur gelangen. Nur Adobe Stock und Pond5 lesen in die Datei eingebettete Keywords.
So viele, wie der Clip hergibt, nicht so viele, wie das Feld zulässt. Adobe nennt 15 bis 35 oft reichlich; Pond5 rät zu 10 bis 20; Getty verlangt Qualität vor Quantität.
Weiterlesen
Quellen
- Adobe-Hilfe, Common reasons for content refusal (aktualisiert 2026-06-11), gelesen 2026-10-27
- Adobe Artist Hub, Maximize Metadata part 3 (undatiert), gelesen 2026-10-01
- Adobe-Hilfe, Account and submission guidelines (aktualisiert 2026-09-03), gelesen 2026-10-27
- Adobe-Hilfe, Generative AI content, gelesen 2026-10-27
- Adobe-Hilfe, Keyword and title best practices (Keyword-Vorschläge), gelesen 2026-10-27
- Shutterstock-Hilfe, Why was my content rejected for title or keywords? (2025-09-13), gelesen 2026-10-27
- Shutterstock-Hilfe, How are keyword and title spamming defined? (2025-07-18)
- Shutterstock-Hilfe, Contributor account and content submission guidelines (2025-09-23), gelesen 2026-10-27
- Shutterstock-Hilfe, Content Publishing Standards: Contextual Metadata (aktualisiert 2026-02-26), gelesen 2026-10-27
- Pond5, Tagging & Pricing Your Files, gelesen 2026-10-27
- Getty Images, Content Partners guide, Artikel 6064, gelesen 2026-10-01
- WoRMS REST web service, AphiaRecordsByName
- Getty Images, Artist Supply Agreement, Artikel 4872 (Keyword-Doping), Suchauszug gelesen 2026-10-27
- Adobe Community, 'False positive account deactivation' (2026-08-07)
- Gemessen in Getty ESP auf einem aktiven Contributor-Konto: Button 'Get suggestions', umgeschriebene Keywords, 2026-09-08
- Antworten von WoRMS und GBIF auf echte, falsch geschriebene und erfundene Namen, gemessen 2026-09-03